
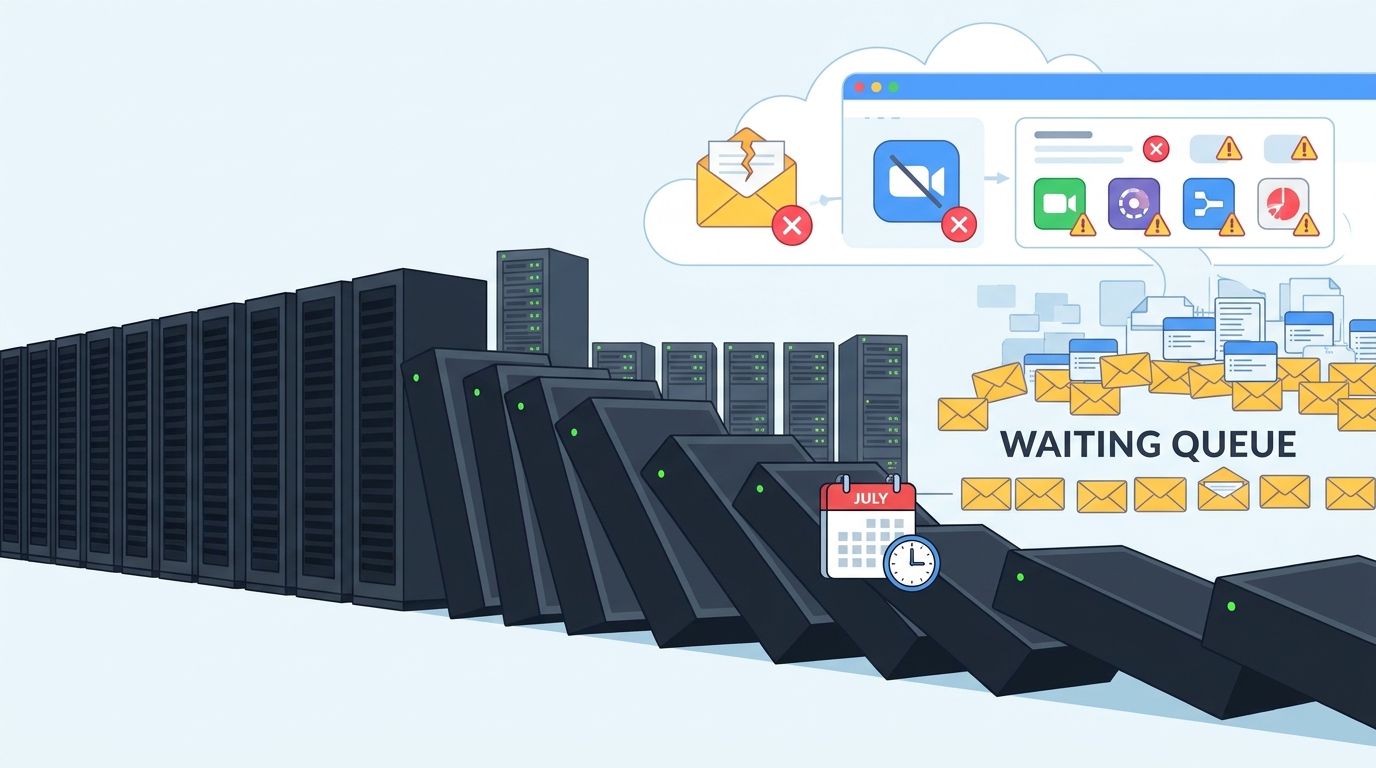
Quase 24 horas sem Outlook, Teams e Copilot têm agora uma explicação oficial. O relatório preliminar da Microsoft sobre o incidente de 12 de novembro aponta para uma alteração de código distribuída a partir de julho, cujo efeito só se revelou mais de três meses depois, quando coincidiu com duas circunstâncias operacionais. A empresa afasta a hipótese de ciberataque.
Resposta rápida: A falha global do Microsoft 365 de 12 e 13 de novembro teve origem técnica e não maliciosa: juntaram-se um defeito de software por detetar, mais tráfego vindo do Teams e menos servidores disponíveis. O serviço está reposto desde 14 de novembro e os clientes não precisam de alterar configurações. Recomenda-se rever o impacto interno, confirmar se há correio em atraso e desconfiar de contactos que usem a falha como pretexto.
Três fatores que só juntos derrubaram o serviço
Os administradores encontram o documento no centro de administração do Microsoft 365, nos registos EX1550543 e MO1550821, conforme anunciou a conta Microsoft 365 Status. Uma versão resumida foi partilhada na rede X por Charles Lamanna, da direção executiva da Microsoft. O ponto de rutura foi a camada de gateways de rede por onde passa o acesso a boa parte do Microsoft 365.
- Defeito latente. O problema técnico chama-se contenção de bloqueios (
lock contention) e vivia num processo interno dos servidores de gateway desde uma correção feita à medida para eles; sob certas cargas, a máquina deixava de responder. - Mais carga. O gateway principal, partilhado com o Exchange Online, recebera cerca de quinze horas antes o tráfego do Teams, desviado do gateway alternativo por um failover que a empresa trata como operação de rotina.
- Menos capacidade. Parte dos servidores estava fora de serviço, algo que a margem de segurança existente absorveria sem dificuldade se fosse o único problema.
O efeito dominó, em que cada servidor que cedia empurrava o seu tráfego para o seguinte e este tropeçava no mesmo defeito, precisou de menos de duas horas para deixar sem resposta mais de 80% dos gateways.
Porque é que os testes não o detetaram
O laboratório da Microsoft não espelhava a produção: o hardware dos ensaios de carga era mais modesto, com menos núcleos, quando o defeito pesa sobretudo nas máquinas mais recentes, e a própria mistura de tráfego diferia da real.
Na tarde de 12 de novembro, as equipas procuraram em vão uma alteração recente que coincidisse com o início do impacto. A antiguidade do código tirou depois à engenharia as saídas de emergência habituais: reversão, distribuição faseada (flighting) e feature flags servem para mudanças recentes, não para algo com meses.
Cronologia do incidente
As horas são UTC, que nesta altura do ano coincide com a hora de Portugal continental.
| Data e hora | Acontecimento |
|---|---|
| Julho de 2026 | Arranca a distribuição da alteração que continha o defeito |
| Cerca de 15 horas antes | O Teams passa a usar o gateway principal, partilhado com o Exchange Online |
| 12 nov., 16:20 | Primeiro alerta no Exchange Online e abertura do registo EX1550543 |
| 12 nov., 18:27 | O registo MO1550821 alarga o âmbito ao Teams, Copilot e Defender |
| 12 nov., 20:00 a 21:00 | Tentativas de mitigação: contorno dos componentes ligados às verificações de saúde, reinício de servidores sem resposta e método alternativo de verificação |
| 13 nov., 07:20 | Parte da capacidade recebe a atualização que repõe o código anterior |
| 13 nov., 10:00 | Primeiros sinais de estabilização, ainda com capacidade abaixo do normal |
| 13 nov., 16:10 | Fim do impacto ativo; segue-se monitorização e escoamento do correio em fila |
| 14 nov. | Os últimos clientes e regiões afetados recuperam o serviço |
| 15 e 16 nov. | Relatório preliminar datado de dia 15 e anunciado na rede X no dia seguinte |
Uma recuperação lenta
O tráfego acumulado à porta transformava cada reinício num novo colapso, o que explica boa parte da demora. Confirmado o diagnóstico, a engenharia abandonou o comportamento introduzido em julho e regressou ao estado anterior, comprovadamente estável. A operação fez-se por lotes de grande dimensão, chegando a abranger metade ou mais de uma região de cada vez. Para o correio, a janela de entrega subiu para 48 horas, de modo a não se perderem mensagens em atraso.
O que devem fazer as organizações
Não há identificador CVE, indicadores de comprometimento nem correção a instalar, porque se trata de uma falha operacional e não de uma vulnerabilidade de segurança. As instalações Windows comuns ficam de fora desta história, já que o código em causa só existia nos gateways do Microsoft 365. Ainda assim, há passos úteis:
- Consultar os registos
EX1550543eMO1550821no centro de administração e arquivar o relatório para documentação interna. - Confirmar com os utilizadores se há mensagens em falta ou atrasadas no período de 12 a 13 de novembro.
- Registar o impacto sofrido e rever o plano de continuidade, incluindo um canal de comunicação alternativo ao email e ao Teams.
- Reforçar os avisos internos sobre fraude: o CNCS pede “atenção redobrada a emails, mensagens e chamadas telefónicas” que invoquem a falha ou finjam vir da Microsoft.
Porque importa em Portugal
O caso entrou no radar do Centro Nacional de Cibersegurança (CNCS), em articulação com entidades homólogas de outros países. A autoridade nacional de cibersegurança irlandesa recebeu a notificação do incidente, segundo o comunicado do CNCS divulgado pela Lusa.
Para as entidades abrangidas pelo Regime Jurídico da Cibersegurança (Decreto-Lei n.º 125/2025, que transpõe a NIS2), o episódio toca em duas áreas das medidas de gestão de risco: a dependência de fornecedores, incluindo os de serviços cloud, e a continuidade das atividades. Uma falha sem atacante pode paralisar uma organização tanto quanto um incidente malicioso.
No plano do RGPD, a disponibilidade é uma das dimensões da segurança do tratamento. Cabe a cada responsável avaliar se a indisponibilidade de dados pessoais teve consequências para os titulares. Fica a faltar o relatório final, esperado até 20 de novembro, onde deverão constar as medidas corretivas adicionais.
Perguntas frequentes
A falha do Microsoft 365 foi um ciberataque?
Não, segundo a empresa. As comunicações oficiais descrevem uma origem técnica, sem indícios de atividade maliciosa nem relação com inteligência artificial.
O que provocou a falha?
O relatório preliminar identifica três causas conjugadas: um defeito de software por detetar, o acréscimo de tráfego após um failover do Teams e uma redução da capacidade de servidores.
É preciso atualizar o Windows ou mudar configurações?
Não. O código defeituoso era exclusivo dos gateways do Microsoft 365 e os clientes ficam dispensados de mexer em tenants ou dispositivos.
Quando é publicado o relatório final?
A versão final está prevista até 20 de novembro de 2026 e deverá detalhar as medidas para evitar a repetição do problema.
Esta informação tem caráter noticioso e baseia-se em dados divulgados publicamente pela Microsoft 365 Status, por Charles Lamanna (Microsoft), pelo BleepingComputer e pelo Centro Nacional de Cibersegurança.